Quick answer
El intercambio central es cobertura de respuesta versus límite de respuesta: el contenido más retrávido es útil sólo si el sistema sabe qué puede acceder un usuario, cuando las fuentes están estancadas y cuando debe utilizar una herramienta, abstenerse o desactivarse.
Last reviewed: 2026-10-09T10:58:13.436ZRAG architecture planner
document ingestion → chunking + metadata → hybrid retrieval → reranking → permission-aware filtering → citation rendering → scheduled re-indexing → tool/API boundary → evaluation harness
Pilot evaluation inputs (%)
1. Pilot evaluation bars
Empty defaults intentionally start at 0 until you enter pilot data.
2. Architecture complexity profile
3. RAG production flow
Evaluation values are yours. Architecture scores are labeled planning complexity, not quality benchmarks.
Tables built for the buying decision
Primary decision table
| Intent | Datos de origen | Acción de bots | Herramienta/integración | Límite de confianza | Despocho humano | KPI |
|---|---|---|---|---|---|---|
| Discovery | Producto aprobado/docs | Explicar con fuentes | Normalmente no | Cobertura de la fuente | Pregunta de ajuste complejo | Tasa de próximo paso útil |
| Apoyo | Base de conocimientos | Retrieve + solución de problemas | Entrada opcional | Pruebas presentes | Cuestión no resuelta y de riesgo | Resolución + aceptación |
| Cálculo | Reglas de oferta + calificación | Pregunta/respuesta | CRM | Campos obligatorios completos | Alto valor/complex | Paso calificado |
| Transaccional | Estado de cuenta en vivo | Explique el límite | API de pedidos y debilización | Logros de la herramienta | Fallo de la herramienta/riesgo | Finalización de la labor |
| A bordo | Docs + contexto de cuenta | Medidas de orientación | API de producto opcional | Seguridad en la misión | Usuario bloqueado | Paso de activación |
Dimensiones de la evaluación RAG
| Dimensión | Pregunta | Categoría de fracaso |
|---|---|---|
| Retrieval | ¿Fue recuperada la fuente de apoyo? | Miss / mal chunk |
| Factualidad | ¿La respuesta coincide con las pruebas? | no respaldados/conflictos |
| Permisos | ¿Sólo se permitía acceder a los datos autorizados? | brecha de límites |
| Latency | ¿Cuál etapa domina el tiempo de respuesta? | retrieval/rerank/model/tool |
| Handoff | ¿Se mantuvo el contexto en la escalada? | repetición/pérdida de contexto |
Turn this planning result into a scoped review.
Send the assumptions, constraints and result summary. WebDesignK can review the architecture/content/implementation boundary, identify missing discovery inputs and return a prioritized next-step scope.
- Bring: current site/product, constraints, integrations and your tool result.
- You get: a scoped recommendation, open questions and implementation priorities.
instantánea de decisión para los chatbots RAG
Generación aumentada por recuperación (RAG) da un contexto seleccionado de un modelo de lenguaje de una fuente de conocimiento externa en el momento de la respuesta. En un chatbot de negocios, el problema de diseño importante no es simplemente "conectar documentos a un LLM." Usted debe definir lo que puede ser recuperado, cómo se aplica el acceso, cómo funciona la frescura y la eliminación, cuando una respuesta debe citar o abstenerse, y cuando una solicitud de transacción debe llamar una herramienta o entregar a una persona. El intercambio central es ** mayor cobertura frente a la frontera de respuesta**.
Lo que decidirá: qué trabajos de conversación pertenecen a la recuperación, que requieren API en vivo, que debe escalar, cómo se ingieren y filtran los documentos, qué datos de evaluación piloto recopilar, y qué controles de producción son necesarios para la frescura, permisos y calidad.
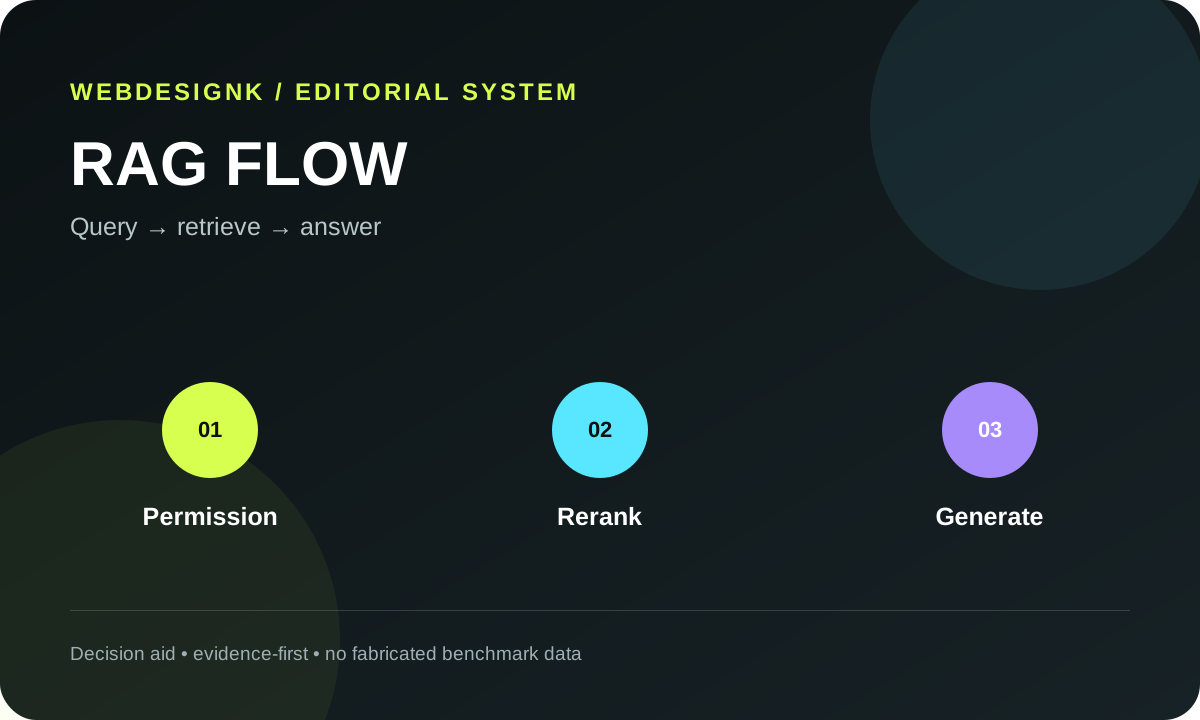
RAG en un diagrama: consulta → recuperación → context → generación
Una interacción típica de RAG comienza con el contexto de consulta y conversación del usuario. La aplicación aplica reglas de identidad y acceso, crea una representación de búsqueda, recupera los trozos candidatos de un corpus indexado y los retrae opcionalmente. Los pasajes seleccionados se insertan en el contexto modelo con instrucciones que describen los límites de respuesta. El modelo produce una respuesta, citas o una abstención; la lógica de aplicación puede en cambio enrutar la solicitud a una herramienta o flujo de trabajo humano.

La documentación actual de OpenAI Retrieval describe las tiendas vectoriales como contenedores que potencian la búsqueda semántica sobre archivos cargados. Ese es un patrón de implementación, no una arquitectura completa de productos RAG. Un sistema de negocios de producción todavía necesita gobernanza de fuentes, permisos, eliminación, evaluación, observabilidad y límites negociables claros.
La recuperación no es igual al uso de herramientas
La recuperación es útil para el conocimiento que puede ser representado de forma segura como contenido de búsqueda: documentación de productos, políticas, manuales, contenido de habilitación aprobado o artículos de soporte. Una herramienta/API es mejor cuando el usuario necesita estado de estado en vivo o específico de cuenta, inventario, disponibilidad de reservas, acciones de facturación, actualizaciones de CRM. No se desvíe rápidamente cambiando los registros transaccionales en un índice de documento simplemente porque el chatbot ya tiene recuperación.
Cuando RAG es apropiado vs directa de la inducción o herramientas
Utilice la indicación directa cuando la información necesaria puede ser proporcionada de forma segura en el impulso o la tarea es transformacional en lugar de factual. Use RAG cuando la respuesta dependa de un corpus demasiado grande o dinámico para incluir directamente y necesita una base específica para la fuente. Utilice herramientas cuando la tarea necesite datos en vivo autorizados o una acción. Use el desvío humano cuando el riesgo, ambigüedad o contexto de cliente supere el límite automatizado.
El planificador de arquitectura anterior obliga a estas decisiones a los módulos en lugar de asumir que cada chatbot necesita la misma pila.
Ingestión de documentos, remojo y metadatos
La ingestión es donde muchos problemas de recuperación posteriores comienzan. Identificadores de fuentes preseleccionados, versión de documento, propietario, horarios, clasificación de acceso y estructura semántica. Limpiar la navegación repetida, cabeceras y caldera antes de indexar. Los límites de la hundimiento deben respetar la estructura de la fuente en lugar de cortar ciegamente cada archivo en el mismo conteo de caracteres.
Los metadatos deben apoyar los filtros que su aplicación necesita: inquilino, producto, región, idioma, fecha efectiva, tipo de contenido o grupo de permiso. No agregue docenas de campos sin un caso de uso de recuperación porque los metadatos también se convierte en algo que el gasoducto de contenido debe mantener la precisión.

Estrategia de recuperación y reencarnación
La búsqueda semántica puede superficializar pasajes relacionados conceptualmente incluso cuando las palabras clave exactas difieren. La palabra clave o la recuperación híbrida todavía puede ser valiosa para los identificadores, códigos de error y nombres de productos. Reranking añade otro paso de selección cuando el conjunto de candidatos iniciales es amplio. La elección correcta depende de su conjunto de corpus y evaluación, no de una tendencia de arquitectura.
Medir la recuperación separadamente de la calidad de respuesta final. Si la fuente pertinente nunca fue recuperada, los cambios rápidos no pueden reparar la evidencia que falta. Si la fuente correcta fue recuperada pero la respuesta fue errónea, investigue la construcción del contexto, los pasajes conflictivos y el comportamiento del modelo.
Permisos y recuperación de inquilinos
Nunca confíes en el modelo para recordar que no mencionar los datos que no debería haber recibido. Aplicar autorización antes de recuperar o filtrar los resultados usando metadatos de identidad/teniente confiables por lo que el contenido prohibido no entra en contexto modelo. Prueba explícitamente casos de participación cruzada y de participación.
Para bots internos, la complejidad de permiso puede ser mayor que los bots de soporte público porque el conocimiento suele seguir los límites de equipo, cuenta o cliente. Decide cómo los cambios de permiso se propagan al índice y qué sucede con los resultados caché.
Citaciones, límites de respuesta y abstención
Una cita debe ayudar al usuario a inspeccionar la fuente que soporta la respuesta. Preserve suficientes metadatos para mostrar el título fuente, el enlace profundo y la versión donde sea útil. Defina cuando el bot debe citar, cuando puede resumir sin citación y cuando debe decir que las fuentes disponibles son insuficientes.

La abstención es una característica del producto, no un fracaso. Un bot que inventa una respuesta segura cuando falla la recuperación es menos útil que uno que pide aclaración, vincula la fuente o escalada pertinente.
Frescura, re-indización y eliminación
La estrategia de frescura debe seguir la fuente. Los documentos de política mensuales pueden tolerar la ingestión programada; el catálogo de cambio rápido o el contenido de conocimiento puede necesitar actualizaciones impulsadas por eventos. Versión de fuente de grabación y timetamp indexado. La eliminación debe eliminar el material de la recuperación, no sólo ocultarlo en la UI fuente.
Prueba los escenarios stale-data deliberadamente: actualiza una fuente, elimina una fuente y cambia un permiso de usuario. Luego verifique lo que el bot puede recuperar después de cada evento. Esto es más útil que asumir una exitosa ingestión inicial demuestra la corrección del ciclo de vida.
Caso de borde: fuentes conflictivas o superpuestas
El conocimiento de negocios es raramente consistente. Dos políticas pueden describir fechas diferentes efectivas; la documentación de los productos puede dar lugar a una liberación; los artículos de apoyo pueden contravenir términos contractuales. Preservar metadatos prioritarios y actualizados eficaces para que la recuperación pueda preferir la versión autorizada. Cuando se recuperan pasajes conflictivos, el asistente no debe fusionarlos silenciosamente en una respuesta segura. Superar el conflicto, prefiera la autoridad designada o despacharla según la política.
Caso de borde: tablas, PDF y documentos visuales
La calidad de la extracción de documentos importa antes de la incrustación. Las tablas pueden perder relaciones fila/columna, orden de lectura PDF puede ser incorrecto y las capturas pueden contener texto crítico que un solo oleoducto de texto nunca indexa. Prueba documentos representativos de cada tipo fuente y conserva cuestiones estructurales en pedazos. Un gasoducto de extracción limpia a menudo mejora la recuperación más que cambiar los modelos de embedding.
Construir consultas del estado de conversación cuidadosamente
Las preguntas de seguimiento como “¿qué hay de la empresa?” pueden depender de contextos anteriores. La reescritura de la consulta puede hacer que la solicitud de recuperación se conserve, pero también puede inyectar supuestos que nunca fueron declarados. Log reescrito consultas durante la evaluación y compararlas con la intención real del usuario. Para los flujos de trabajo de alto valor, incluya pruebas donde el giro anterior cambie el límite de fuente o permiso correcto.
Retrieval híbrido e identificadores
La similitud semántica es útil para preguntas conceptuales, mientras que la combinación lexical exacta puede ser crítica para los SKUs, códigos de error, IDs de política y nombres. Una estrategia híbrida puede combinar ambas señales antes de reenvainar. Evaluar con su verdadero corpus; los diagramas de arquitectura deben explicar el mecanismo, no implica que una receta de recuperación es universalmente mejor.
Retrieval, respuesta y éxito del flujo de trabajo separados
Utilice al menos tres etiquetas cuando revise las conversaciones piloto. El éxito de recuperación pregunta si las pruebas adecuadas estaban disponibles para el modelo. Respuesta de éxito pregunta si la respuesta fue fiel, útil y apropiadamente citada. El éxito de la actividad pregunta si el usuario ha completado el trabajo de negocios, incluyendo la correcta ejecución de herramientas o la escalada. Un sistema puede recuperar perfectamente y todavía falla el flujo de trabajo; una respuesta útil puede violar un límite de permiso.
Cree casos de regresión por cada grave fracaso. Almacene la fuente o acción rápida, esperada, el contexto de usuario/tendiente y la regla de aceptación. Re-correr el conjunto cuando la ingestión, clasificación, impulsos, modelos o herramientas cambian. Esto convierte los incidentes de producción en controles de calidad duraderos en lugar de parches de una sola vez.
Privacidad, retención y ciclo de vida de origen
Decide qué conversaciones, recuperó trozos, salidas de herramientas y rastros de evaluación se mantienen y durante cuánto tiempo. Mantenga los datos mínimos necesarios para la revisión de la calidad y los incidentes, separe los registros de producción de los conjuntos de datos de evaluación y asegure que los requisitos de eliminación puedan propagarse a través de las tiendas de origen, los índices y los caches. Las clases de fuentes sensibles pueden requerir controles adicionales o la exclusión de las exportaciones automatizadas de evaluación.
Un sistema de recuperación también debe detectar los enlaces de fuentes rotas y los propietarios de puestos. Si una fuente no tiene un propietario responsable, su autoridad se degradará incluso si las incrustaciones siguen siendo técnicamente verificables.
Conjunto de datos y categorías de fracasos de evaluación
Construir una evaluación basada en trabajos de conversación reales: descubrimiento, apoyo, calificación, a bordo y intenciones transaccionales. Incluye preguntas de feliz-pataje, redacción ambigua, información faltante, contenido de establo, fuentes conflictivas, límites de permiso, instrucciones adversarias y solicitudes que deben invocar una herramienta.
La recuperación de puntuación se golpeó por separado de la aceptación de la respuesta. Seguimiento de escalada o contención según el caso de uso en lugar de tratar la escalada más baja como universalmente mejor. Para escenarios de alto riesgo, una escalada correcta puede ser la condición de éxito.
Controles de latencia y los costos
Latency se acumula a través de la autenticación, transformación de consultas, recuperación, reranking, llamadas de herramientas y generación de modelos. El equipo sabe dónde se gasta el tiempo. Sólo cuelga donde la frescura y los permisos lo hacen seguro. Limitar el contexto recuperado a evidencia útil en lugar de enviar grandes pasajes redundantes.
El análisis de costos debe utilizar su tráfico, operaciones de recuperación, uso de modelos e infraestructura. El artículo evita intencionalmente un “costo universal por respuesta RAG” porque la arquitectura y el uso varían materialmente.
Lista de verificación de la producción
Antes de la implantación, verifique la propiedad de la fuente, el monitoreo de la ingestión, la aplicación de permisos, enlaces de citas, comportamiento de abstención, límites de herramientas, eliminación, conjuntos de datos de evaluación, carga útil de mano humana, localización de latencia y propiedad de incidentes. Comience con un trabajo de conversación encuadernado y un piloto reversible. Ampliar sólo cuando se entiendan las categorías de falla observadas y el equipo tiene un proceso para convertirlas en pruebas.
Al entregar a una persona, preservar el resumen de conversación, la razón de escalada, las fuentes ya mostradas, autenticar identidad o estado de consentimiento cuando sea aplicable, y cualquier acción de herramienta ya intentó. No haga que el cliente repita todo el problema simplemente porque la automatización llegó a su límite.
Preguntas frecuentes
¿Es RAG igual que el ajuste?
No. Los suministros RAG recuperados contexto en el momento de respuesta; cambio de ajuste de comportamiento modelo a través de ejemplos de entrenamiento.
¿Necesita cada chatbot de negocios una base de datos vectorial?
No. Las tareas pequeñas/estáticas pueden usar contexto directo, mientras que las acciones de cuenta en vivo necesitan herramientas. La infraestructura de recuperación debe seguir el trabajo de conocimiento.
¿Cómo se deben aplicar los permisos de inquilino?
Mantenga la autorización fuera del modelo y evite que el material no autorizado entre en los resultados de recuperación o en el contexto modelo.
¿Qué debería medir un piloto de RAG?
Medir la recuperación de golpes, aceptación de respuestas/factualidad, escalada o contención correctas, finalización de objetivos, latencia y categorías de fracaso utilizando sus propios datos piloto.
Sources and assumption boundaries
Fast-changing platform, pricing and search claims were reviewed on 2026-10-09T10:58:13.436Z. Interactive scores and scenarios are clearly labeled planning models, not sourced market benchmarks.
- OpenAI API — Retrieval Documentación actual de la recuperación de OpenAI/vector-store; revisado 16 de septiembre de 2026.
- OpenAI API — Búsqueda de archivos Documentación actual de la herramienta de búsqueda de archivos hospedados; revisado 16 de septiembre de 2026.
- NIST - Marco de gestión del riesgo de AI Referencia de gobernanza para la gestión del riesgo de IA; revisión 16, 2026 de septiembre.