Quick answer
Trate a SEO programático como sistema editorial, no como generador de URL. Define una intención repetible, prueba que sus datos y módulos crean valor específico de página, publica una muestra revisada, la expone a través de enlaces internos rastreables, y expande sólo cuando la indexación y evidencia de usuario permanecen saludables. Las políticas de spam de Google explícitamente llaman fuera abuso de puerta y contenido escalado creado principalmente para manipular las escalas.
Last reviewed: 2026-09-19T00:00:00.000ZProgrammatic-page publish gate
Score one proposed page family before you scale it. The gate is a disclosed WebDesignK planning model—not a Google ranking factor, traffic forecast, or guarantee of indexation. Inputs stay in this browser.
Keep the family out of the index while improving weak dimensions → Add page-specific data or modules → Strengthen contextual internal links → Re-run the quality sample before launch
1. Impact / confidence / effort priority
Priority uses the transparent formula impact × confidence ÷ effort.
Takeaway: entered priority score is 3; it compares your own backlog items only.
2. Implementation coverage
Track the share of the page-family plan you have actually reviewed.
Takeaway: average entered coverage is 55%.
3. Quality-gate ring
The ring compares your weighted quality score with the threshold you selected.
Takeaway: the score is below your selected threshold; hard blockers still override the score.
4. Quality-dimension heatmap
Use this to spot the weakest reason a generated URL deserves to exist.
Text fallback: Intent uniqueness 3.0/5, Data uniqueness 3.0/5, Template variation 3.0/5, Index threshold 3.8/5, Internal links 2.0/5.
Assumption note: quality weights and the launch/hold/block labels are WebDesignK planning rules. Priority and coverage use only values you enter. Google does not publish these scores or thresholds.
Tables built for the buying decision
Primary decision table
| Cuestión / oportunidad | Pruebas | Plantilla/páginas afectadas | Impacto | Confianza | Motivo | Prioridad | Propietario | Fijar | Validación |
|---|---|---|---|---|---|---|---|---|---|
| Superposición de la intención entre páginas generadas | Mapa de consultas a página muestra múltiples URLs respondiendo a la misma tarea | Ubicación + plantilla de servicio | 5/5 | 4/5 | 3/5 | Alto | SEO + Producto | Consolidar la intención o agregar un trabajo y evidencia específico de página | Muestra de re-crawl; verificar títulos distintos, contenido principal, canónicas y enlaces internos |
| Datos genéricos de origen | Las filas difieren sólo por nombre/ubicación mientras que los atributos son idénticos | Directorio de integración | 5/5 | 5/5 | 4/5 | Alto | Datos + Contenido | Agregue atributos autorizados, estados de compatibilidad, requisitos de configuración y propiedad mantenida | Registros de muestras contra la fuente de la verdad; rechazar registros incompletos de salida indable |
| Debilidad del descubrimiento | URLs generadas aparecen en mapa de sitio pero no reciben enlaces internos casi sin contexto | Familia de la categoría de mercado | 4/5 | 4/5 | 2/5 | Alto | SEO + Ingeniería | Agregue las rutas de navegación, los vínculos entre padres y niños y entidades conexas donde resulten útiles | Crawl de navegación / búsquedas y páginas confirman son descubiertas sin la dependencia de mapa de sitio |
| Espacio de parámetro no controlado | Filtros/ surtidos crean muchas combinaciones arrastrables no destinadas como landing pages | Páginas de categoría facetadas | 5/5 | 4/5 | 4/5 | Alto | Ingeniería + SEO | Defina estados de landing-page permitidos y bloquee o neutralice estados no investigativos | Parámetro de Crawl patrones; compare conjunto indexable con inventario aprobado |
| Schema copiado en páginas sin coincidir con datos visibles | Los campos de datos estructurados repiten o contradicen el contenido de la página | Páginas de comparación | 3/5 | 5/5 | 2/5 | Mediana | Ingeniería + Contenido | Generar esquemas sólo desde campos visibles verificados | Validar URLs representativas y comparar JSON-LD con contenido renderizado |
| Páginas generadas en forma de escalón o de orfanato | La entidad subyacente es inactiva o el registro de fuente no tiene ningún propietario actual | Directorio de la ciudad / proveedor | 4/5 | 4/5 | 3/5 | Alto | Operaciones de datos | Agregue el estado de frescura, propietario, regla de jubilación y redirección/noindex decisión | Informe de registro de datos fijos programado más cheques de URL muestreados después de la jubilación |
| Familia de página reutilizable fuerte | Intención distintiva, datos únicos, módulos útiles, enlaces y propiedad de fuentes sostenibles | Base de datos de comparación | 5/5 | 4/5 | 4/5 | Alto | SEO + Producto + Ingeniería | Inicie una muestra controlada y amplíe sólo después de QA | Comparar las muestras presentadas/descubiertas/indeñadas y los resultados de los usuarios antes de aumentar el inventario |
Diseño de calidad de página-familia
| Página de familia | Datos de origen | Módulos únicos | Enlaces internos | Regla de Indización | Puerta de calidad |
|---|---|---|---|---|---|
| Ciudad + páginas de servicio | Disponibilidad de servicios reales, pruebas locales, horas/cubierta, limitaciones específicas para el lugar | Disponibilidad local, prueba, alternativas cercanas, ubicación FAQ cuando realmente diferente | Región hub → ciudad; ciudades cercanas; páginas de servicio relevantes | Índice solamente ciudades con servicio diferenciado real y evidencia | Bloquear si la página es un cambio de nombre de ciudad que embudos al mismo destino genérico |
| Directorio de integración | Compatibilidad mantenida, método de auth, dirección de datos, pasos de configuración, limitaciones | Configuración de la ruta, mapa de campo, acciones apoyadas, solución de problemas, alternativas | Producto → integraciones hub → integración; integraciones relacionadas | Indecciones soportadas/mantenidas con suficiente detalle útil | Registros bloques sin valor de implementación de estado de soporte verificado o página específica |
| Categorías de los mercados | Inventario, atributos, disponibilidad, taxonomía y entidad estado | Filtros con URLs, comparaciones, resúmenes de inventario, guía del comprador | taxonomía de parientes, hermanos, páginas de entidad, subcategorías curadas | Lista estable de índices estados con demanda y inventario útil | Bloquear combinaciones vacías/finales y permutaciones de filtros incontroladas |
| Base de datos de comparación | Atributos comparables con definiciones, fuente y tiempos de actualización | Diferencia: aspectos destacados, metodología, filtros, enlaces de evidencia | Categoría hub, páginas de entidad, comparaciones conexas | Comparaciones de índice con entidades válidas y diferenciadores significativos | Bloquear páginas de par sintético que repiten un párrafo genérico |
| Páginas de uso / industria | Cartografía de capacidades verificadas, flujos de trabajo, limitaciones y pruebas | diagrama de flujo de trabajo, requisitos, notas de aplicación, pruebas de casos relevantes | Centro de solución, capacidades conexas, pruebas pertinentes | Índice sólo cuando el caso de uso cambia la decisión o aplicación | Bloquear los intercambios adjetivos que no cambian la respuesta del comprador |
Turn this planning result into a scoped review.
Send the assumptions, constraints and result summary. WebDesignK can review the architecture/content/implementation boundary, identify missing discovery inputs and return a prioritized next-step scope.
- Bring: current site/product, constraints, integrations and your tool result.
- You get: a scoped recommendation, open questions and implementation priorities.
Lo programativo SEO en realidad es
El SEO programático es un enfoque editorial en el que los datos estructurados y las plantillas reutilizables crean muchas páginas útiles de búsqueda para las intenciones repetibles. El método se justifica cuando el intent repite pero la respuesta cambia genuinamente por entidad, ubicación, integración, categoría, comparación u otra dimensión de datos. El intercambio central es cobertura versus control editorial: la automatización puede hacer las páginas pertinentes económicamente posibles, pero cada URL indable adicional aumenta el costo de los datos malos, la intención duplicada, la vinculación interna débil y la lógica de plantilla no revisada.
Las políticas actuales de spam de Google no definen la publicación programática como spam. Sin embargo, describen ** abuso de puerta** como páginas creadas para consultas similares que embudo usuarios hacia otro destino, y ** abuso de contenido escalada** como grandes cantidades de contenido original creado principalmente para manipular rankings en lugar de ayudar a los usuarios. Esa distinción es el límite operativo para un programa responsable.
Lo que decida: si la familia de la página tiene una intención repetible legítima; qué datos de origen hace que cada URL sea útil; qué módulos deben variar; cómo se descubren las URL; qué páginas califican para indexación; cómo QA cambia a 10, 100 y 10.000 URLs; y qué evidencia activa expansión, consolidación o poda.
El principio operativo: generar candidatos, no páginas indizadas automáticas
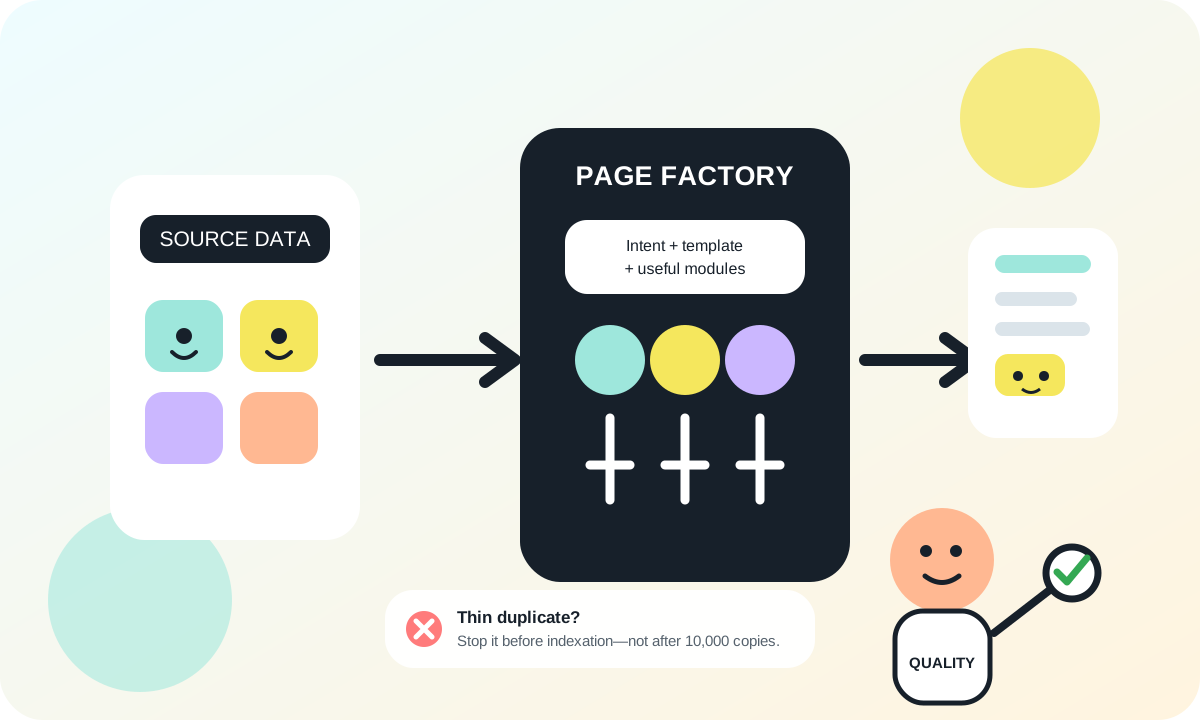
El modelo mental más seguro es permitir que la automatización genere páginas candidatas. Una política de publicación separada decide si cada candidato se convierte en indigno. Esa política puede ser determinista donde los datos lo permiten: campos de origen requeridos, estado de entidad, módulos mínimos únicos, válidos canónicos, enlaces padres, fecha de frescura y sin bloqueo QA no resuelto. La revisión humana muestra el sistema a nivel de plantilla y de periferia en lugar de pretender que cada URL puede recibir producción editorial a medida.
Esto separa la escala de la indexación. Su base de datos puede contener 100.000 entidades mientras que sólo el subconjunto que cumple el contrato de página-familia está expuesto a los motores de búsqueda. La puerta interactiva arriba utiliza umbrales editoriales transparentes para hacer que la conversación sea concreta; su puntuación es una herramienta de planificación, no una métrica de Google.
Cuando las páginas programáticas están justificadas
Las páginas programáticas crean valor cuando un usuario se beneficia de aterrizar directamente en una respuesta específica que sería incómodo o costoso mantener manualmente. Ejemplos incluyen una página de integración que documenta un método de autenticación específico y flujo de datos soportados, una categoría de mercado que expone inventarios y atributos reales, una página de ubicación que refleja la disponibilidad local real, o una página de comparación cuyos datos de origen cambian la decisión.
Las oportunidades más fuertes suelen tener cuatro características. Primero, la intención del usuario repite previsiblemente. En segundo lugar, los datos subyacentes son autorizados y sostenibles. En tercer lugar, la página puede exponer variaciones útiles más allá de una sustitución token. En cuarto lugar, el sitio tiene una estructura de navegación o enlace interno que hace que las páginas sean parte de un producto coherente en lugar de entradas de búsqueda aisladas.
Buena escala es una capacidad de producto, no una cuota de contenido
Un mercado de viajes puede tener una página legítima para cada destino porque el inventario, la estacionalidad, los barrios, el transporte y las opciones cercanas difieren. Una compañía de software podría tener páginas de integración porque los pasos de configuración, permisos y objetos compatibles difieren. En ambos casos, la página programática es útil incluso si el usuario nunca llegó de Google. Esa es una prueba práctica: si la página no tiene razón para existir dentro del producto o la arquitectura del sitio, la demanda de búsqueda por sí sola es una justificación débil.
Un signo de advertencia es un breve que comienza con “encontramos 30.000 palabras clave” pero no puede nombrar el sistema fuente de verdad, decisión específica de página, propietario de contenido o ruta de navegación. El volumen de palabras clave puede ayudar a priorizar una familia de página válida; no debe inventar el valor de producto de la familia.
URL y diseño taxonomía
Construya un mapa de consulta a página antes de crear plantillas. Escribe la tarea de búsqueda en lenguaje simple y define la entidad o dimensión que cambia la respuesta. Luego especificar qué página familia es dueña de ella. Un mapa útil impide que varias familias generadas compitan por la misma intención y expone situaciones en las que un solo centro fuerte es más apropiado que miles de hojas.
Por ejemplo, “¿El producto se integra con el producto B?” puede mapear a una plantilla de integración-detalles. “Las mejores integraciones contables” pertenece a una categoría de integraciones o una comparación editorial, no a cada página de integración individual. “Diseñador web en Austin” puede justificar una página de ubicación sólo cuando el negocio realmente sirve a Austin y puede mostrar disponibilidad o evidencia local. Si cada página de la ciudad dice lo mismo y envía al visitante a la misma página de contacto genérica, la arquitectura comienza a parecerse al patrón de la puerta de Google advierte.
Mapa de intención antes de la sintaxis URL
No empieces por decidir que la URL será/city/service/o/integrations/vendor/. Primero decidir si el trabajo del visitante es de navegación, comparativa, transaccional, local, compatible o informativo. Luego elige una jerarquía que representa ese modelo de información y puede ser navegada normalmente. La estructura URL debe seguir la taxonomía en lugar de convertirse en taxonomía.
Crear una regla de propiedad para las colisiones: si dos candidatos responden sustancialmente a la misma tarea, decide si fusionar datos en una página, hacer una página un padre y el otro un niño más estrecho, o mantener a uno no indexable. Esta regla impide que la canibalización se convierta en un proyecto de limpieza después de que existan miles de páginas.
Modelo de datos y calidad de fuente
La calidad de SEO programática está ligada por la calidad de fuente-datos. Una plantilla no puede crear diferenciación significativa de un conjunto de datos que contenga sólo un nombre, una mancha y una descripción genérica. Define los campos que hacen útil la página, de donde viene cada campo, que lo posee, con qué frecuencia cambia y qué sucede cuando se pierde.
Para un directorio de integración, campos útiles podrían incluir el estado de soporte, método de autenticación, objetos/acciones, dirección de sincronización, requisitos de configuración, limitaciones, enlaces de documentación y la fecha de verificación anterior. Para una familia de ubicación/servicio, podrían incluir cobertura de servicios, limitaciones de nombramiento o entrega, equipo local o prueba, reglamentos pertinentes cuando proceda, y alternativas cercanas. Los campos exactos difieren por el negocio; la disciplina es hacerlos explícitos.
Datos autoritarios separados del enriquecimiento editorial
Almacene la capa fáctica separadamente de la prosa generada. Si una integración de producto deja de ser compatible, el estado debe cambiar en una fuente de verdad y propagarse a la página, mapa de sitio y comportamiento interno-link. Los módulos editoriales pueden explicar las implicaciones, pero no deben ser el único lugar donde vive un hecho crítico.
Agregue validación a la ingestión. Rechazar identificadores malformados, combinaciones imposibles, falta de propiedad requerida y registros de estalla antes de llegar a la capa de renderización. Para datos externos, mantenga la procedencia y una fecha de recuperación/actualización. Si un campo no puede ser verificado, omitirlo o etiquetar incertidumbre en lugar de llenar la brecha con confianza sintética.
Caso de borde: registros generados por el usuario o suministrados por los socios
Los directorios suelen recibir registros de clientes, socios o vendedores. Tratar esos insumos como no se fijó hasta que se validó. Requiere campos mínimos estructurados, normalice la taxonomía, detecte duplicados y defina una vía de moderación. La indización debe depender del mismo contrato de calidad independientemente de quién haya creado el registro. De lo contrario, el camino más débil de la ingestión puede crear la superficie delgada más grande.
Diseño de plantilla y valor único
Una plantilla escalable necesita más que sustantivos variables. Enumere cada módulo y lo clasifica como invariable, variable de datos, condicionalmente renderizado o editorial. Entonces pregunte qué módulos crean valor de decisión. Un título y una miga de pan pueden ser una estructura invariable. Los datos de compatibilidad, inventario, prueba local, atributos de comparación, pasos de configuración, precios donde estén disponibles legítimamente, FAQs y entidades relacionadas pueden variar de los datos.
Objetivo para la variación compositivo, no al azar. Si una integración apoya OAuth y webhooks, muestre los módulos de configuración y evento pertinentes. Si no soporta ninguno, no genere relleno parafraseado para hacer que la página se vea más tiempo. Una página más corta con información precisa es mejor que una página grande acolchada con prosa intercambiable.
Los módulos condicionales deben fallar cerrados
Un módulo no debe rendirse simplemente porque existe un campo. Defina elegibilidad. Un bloque de “prueba de clientes” necesita una referencia de caso aprobada, no cualquier nombre de empresa en la base de datos. Un bloque de “en los alrededores” debe utilizar lugares reales útiles, no vecinos geográficos arbitrarios. Una tabla de comparación debe requerir campos de origen comparables y definiciones claras.
Plantilla QA debe incluir el estado vacío, los datos más ricos y contradictorios. El registro más rico suele ocultar problemas de diseño; el escaso registro revela si la plantilla todavía merece indexación.
Controles de índice
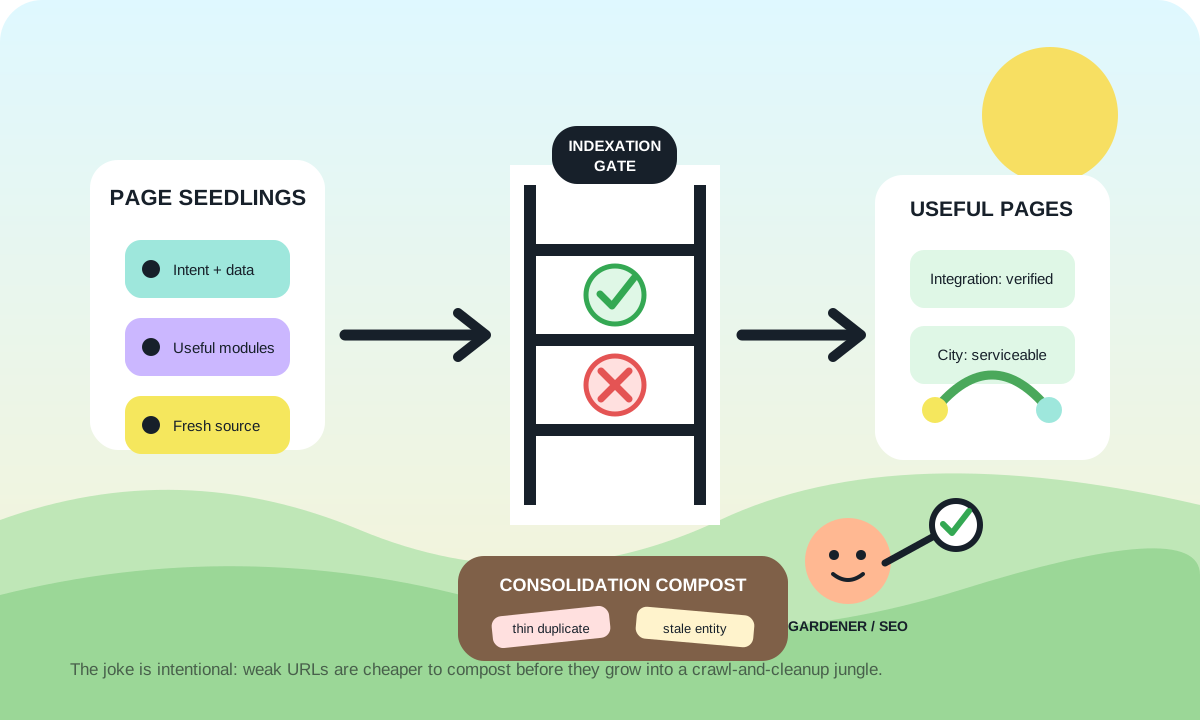
La indexación debe ser una máquina estatal explícita. Un candidato puede ser redactado, bloqueado, publicado-noindex, publicado-indexable, retirado o redireccionado. Cada transición necesita criterios. Esto es más fiable que asumir que cada ruta generada pertenece en el mapa de sitio y añadir reglas de limpieza más adelante.
Un contrato indable práctico podría requerir: entidad activa; intención distinta; campos de origen requeridos presentes; al menos uno o más módulos de valor específicos de página; autocánica válida; respuesta estable de 200; enlace interno contextual de un padre aprobado; título útil/H1 generados de atributos verificados; no fallo QA crítico; y una señal actual de propietario/frescencia. Esos son controles de ejemplo, no umbrales universales de Google.
La documentación de Google sitemap recomienda incluir las URL canónicas que desea aparecer en Búsqueda en lugar de cada variante accesible. La presentación del sitio web es también una pista, no una garantía de arrastre o indexación. Adherir la membresía de sitio con su estado de publicación para que el mapa de sitio se convierta en una expresión limpia de inventario previsto.
Los canónicos consolidan los duplicados; no justifican el mal inventario
Google explica que páginas duplicadas o muy similares pueden ser agrupadas y seleccionadas por un representante canónico. Utilice señales canónicas consistentes cuando múltiples URL válidas representan el mismo contenido, pero no generan un gran inventario débil y esperanrel=canonicalpara transformarlo en un programa útil. Si una URL no tiene un trabajo distinto, la mejor solución es generalmente evitar crearla o indexarla.
Arquitectura de enlace interno
Las páginas programáticas deben pertenecer a la arquitectura de información del sitio. Construir centros de padres, páginas de categoría, relaciones de entidad, escalas de pan y enlaces de hermanos contextuales para que los usuarios puedan descubrir las mismas familias de página sin motores de búsqueda. Una página que existe sólo porque aparece en un mapa de sitio XML es técnicamente descubierta pero a menudo revela una arquitectura de producto débil.
Las reglas de enlace deben ser lo suficientemente deterministas para probar. Una página de ubicación puede conectarse a su padre de la región, lugares de servicio cercanos y detalles de servicio relevantes. Una página de integración puede vincularse con el centro de integración, el flujo de trabajo de productos soportado e integraciones conexas. Una categoría de mercado puede vincularse con las categorías de padres e hijos más con entidades válidas. Evite las redes de “páginas relacionadas” indiscriminadas que conectan miles de URL sin valor semántico.
El descubrimiento de la medida como problema de grafito
Seguimiento de candidatos huérfanos, clic en profundidad para páginas prioritarias, cobertura de padres, enlaces internos rotos/redirigidos y el número de páginas indignos sin enlaces contextuales. A gran escala, estas métricas son a menudo más accionables que navegar manualmente un puñado de URLs. También ayudan a distinguir un problema de indexación de un problema de descubrimiento.
Riesgos de crawl-presupuesto y contenido duplicado
Para sitios muy grandes o con frecuencia cambiantes, la guía de Google sobre presupuestos recomienda controlar espacios de URL duplicados y de bajo valor, manteniendo mapas de sitios enfocados en URL canónicas, y evitando patrones de servidor o de terror suave que desperdician los rastreos. La mayoría de los sitios pequeños no necesitan un proyecto de presupuesto por rastreo especial, pero un sistema programático puede crear rápidamente grandes inventarios de URL; es por eso que los controles de URL-estado, reglas de parámetro, comportamiento de respuesta estable y la membresía de sitio canónico limpio deben diseñarse antes de la expansión.
Los ejemplos de puerta-abuso de Google incluyen páginas dirigidas a consultas similares que los usuarios embudos a un destino final y páginas sustancialmente similares posicionadas más cerca de los resultados de búsqueda que una jerarquía navegable clara. La pregunta de diseño programático es, por tanto, simple: ¿Esta URL completa una tarea de usuario significativa, o simplemente captura una consulta antes de enviar al usuario a otro lugar?
El abuso de contenido escalado se centra igualmente en grandes volúmenes de contenido original creado principalmente para manipular los rankings. El método de creación puede ser automatización, AI o algo más; el problema es la falta de valor de usuario. No use prose generada como una capa de singularidad sobre hechos idénticos. Los motores de búsqueda y los usuarios pueden ver a través de páginas cuya única diferencia material es un lugar o nombre de producto sustituido.
Prueba de puerta para páginas locales
Antes de crear cientos de páginas de la ciudad, pregunte si el servicio, disponibilidad, prueba, proceso o decisión difieren genuinamente. Si la respuesta es no, un centro regional o página de servicio puede ser más útil. Si la respuesta es sí, codifica las diferencias locales como campos de datos requeridos y bloquea páginas que no pueden satisfacerlas.
Prueba de intención duplicada para comparaciones
Los sistemas de comparación de pares pueden explotar combinatoriamente. No publiques todos los pares posibles simplemente porque la base de datos puede. Requiere dos entidades válidas, atributos comparables significativos, una verdadera pregunta de audiencia y suficiente evidencia diferenciada para apoyar la comparación. De lo contrario, mantenga el par fuera del inventario indable.
QA y vigilancia a escala
El método QA debe evolucionar a medida que crece el inventario. En aproximadamente diez páginas, revise cada página manualmente a través de datos móviles/desktop, datos estructurados, enlaces, renderización y exactitud de la fuente. En cien páginas, todavía muestra manualmente registros representativos y de casos de borde, pero agrega afirmaciones automatizadas en toda la familia. A las diez mil páginas, el sistema necesita controles continuos: validación de fuentes, pruebas de plantilla, muestreo de rastreo, conciliación de mapas de sitio, monitoreo de indexación, detección de registros de datos y alerta.
Estos números son ejemplos operativos para cómo cambiar la técnica de QA, no los umbrales de Google. El principio clave es que la revisión manual pasa de cada URL a cada regla más registros representativos mientras que la cobertura automatizada se expande.
Construir una matriz QA sintética
Crear accesorios para el registro más escaso válido, más rico registro válido, campos opcionales desaparecidos, campos requeridos perdidos, caracteres especiales, nombres largos, entidades relacionadas vacías, combinaciones no soportadas, entidades retiradas y localización si es aplicable. Ejecutarlos a través de la presentación y afirmar el estado de publicación esperado. Esto atrapa regresiones de plantilla antes de que los datos de producción los encuentre.
Agregue cheques de producción para código de estado, canónico, robots/indexabilidad, H1/título presencia, cuenta de enlace interno, validez estructurada-data cuando se utiliza, fallas de imagen y texto accidental de marcador de lugar. Un cheque fallido debe identificar la regla de plantilla/datos, no crear diez mil entradas separadas.
umbrales de calidad para la publicación
Medir el sistema en capas. Eligibilidad pregunta si las URL son técnicamente indignos y descubribles. Coverage pregunta qué URLs se han arrastrado e indexado. El usuario pregunta si los usuarios que llegan a la familia se comprometen con el valor específico de la página y completan la próxima tarea. Operaciones pregunta cuántas actas se han estancado, roto o requieren corrección manual.
No establezca reglas de poda alrededor de un solo corte de tráfico. Una página de bajo volumen todavía puede ser útil para una tarea rara de alto valor; una página de alta impresión puede ser pobre si responde a la intención equivocada. Combinar evidencia: registro de fuentes fijas, agrupación persistente duplicada/canónica, sin contenido distinto, sin trayectoria de navegación, ninguna entidad válida, comportamiento repetido suave-404, o resultados consistentemente pobres en relación con el trabajo previsto.
Remedir después de los cambios sin sobreponer la causalidad
Después de cambiar las reglas de lógica o indexación de plantilla, verifique el despliegue inmediatamente, luego permita tiempo suficiente para arrastrarse y reprocesar antes de sacar conclusiones de búsqueda. Google señala que la reevaluación y la reevaluación pueden tomar tiempo y no garantiza cuando se indexará una URL. Uso de la consola de búsqueda, registros de servidores y muestras de rastreo para observar cambios estatales. Para los resultados de negocio, elija una ventana de observación consistente con su volumen de tráfico normal y ciclo de ventas en lugar de declarar un número universal de días.
Mantenga un registro de cambios con fecha de implementación, familia de página afectada, efecto técnico esperado y consulta de validación. Esto convierte un cambio de indexación futuro en un evento diagnosticable en lugar de un vago incidente “programamático SEO dejó de funcionar”.
Ejemplos de familias de buenas páginas
Entre los ejemplos más sólidos de página figuran las páginas de ciudad/servicio respaldadas por la disponibilidad y la prueba locales reales, los directorios de integración mantenidos con campos de compatibilidad específicos de configuración, las categorías de mercado construidas con inventario en vivo y taxonomía intencional, y las bases de datos de comparación cuyos atributos verificados y metodología cambian materialmente por entidad. La tabla de decisiones de la página-familia arriba hace que el dato fuente, módulo, enlace, indexación y contrato de calidad explícito para cada patrón.
Antes del lanzamiento, confirme el mapa de consultas a página, propietarios de fuentes, campos requeridos, reglas de publicación-estado, URL/política canónica, inclusión de mapas de sitio, gráfico de enlace interno, plantillas, eventos de análisis, accesibilidad, datos estructurados cuando sea apropiado, monitoreo y comportamiento de jubilación. Luego lanzar una muestra controlada y validarla en el ambiente de renderización real.
Gobernanza importa porque los sistemas programáticos siguen publicando después de la reunión de lanzamiento. Nombres propietarios de taxonomía, calidad de datos, código de plantilla, reglas editoriales, política de SEO y respuesta a incidentes. Cualquier equipo que cambie un esquema de origen debe saber qué familias de página dependen de él. Cualquier equipo que cambie una plantilla debe tener una suite de regresión. Cualquier equipo que añada una nueva dimensión de página debe documentar cómo afecta el conteo de URL y la propiedad de intención.
Atraso en la implementación: convertir los hallazgos en tareas de navegación
Utilice la tabla de acción arriba como el formato de edición: ** issue/opportunity → evidencia → impact → confianza → esfuerzo → prioridad → propietario → fijar → validación**. Mantenga el impacto, la confianza y el esfuerzo como sus propios insumos de planificación en lugar de pretender que son puntajes universales de SEO. La mini herramienta visualiza ese mismo principio.
Un buen boleto está orientado a raíz. “Fix 4.200 páginas delgadas” no es factible. “La plantilla de integración hace un módulo de configuración vacío cuandoauth_methodes nula; la indexación de bloques hasta que existan campos de soporte necesarios; validar con la fijación de escasos más la muestra de los rastreadores de producción” es accionable y puede cerrar miles de síntomas con una sola fijación.
Una secuencia de despliegue segura
- Probar los datos de intención y fuente con una muestra revisada manualmente.
- Construir las afirmaciones de plantilla/datos y la máquina de estado de indexación.
- Exponga la muestra a través de enlaces internos reales y el inventario de mapas de sitio canónicos.
- Verificar la renderización, análisis, señales canónicas/de indexación y utilidad del usuario.
- Ampliar en cohortes así que las regresiones tienen un radio de explosión atado.
- Revise la cobertura, los datos de estall y los patrones duplicados antes de cada expansión.
- Mantenga un camino de noindex/consolidación reversible para registros débiles.
SEO programático funciona cuando la escala se gana por ** valor repetible**. Si los datos y el valor del producto justifican la escala, la plantilla puede convertirse en una superficie de adquisición duradera. Si no lo hacen, generar más URLs solo multiplica un problema de calidad. WebDesignK puede ayudar a diseñar el contrato de datos, plantillas, sistema de enlace interno, puertas de indexación y bucle de medición para que las páginas merecen ser indexadas antes de que el inventario se vuelva caro para desbloquear.
Flujo de trabajo de herramientas y automatización
Trate el flujo de trabajo como un oleoducto de publicación controlado: validar registros de fuentes, crear candidatos de página, renderizar plantillas en un entorno de previsualización, ejecutar cheques técnicos automatizados, casos de borde de muestra editorialmente, luego aplicar la decisión índice/noindex. La automatización debe hacer que la política sea repetible; no debe evitar la política. Mantenga la validación de datos, comprobaciones de renderización, descubrimiento de enlaces, validación canónica/esquema y elegibilidad de indexación como pasos observables separados para que los fallos sean diagnosticables.
Una implementación práctica puede colar entidades cambiadas, renderizar sólo candidatos afectados, comparar campos y módulos de contenido requeridos contra el contrato de página-familia, arrastrar la salida de previsualización, y publicar sólo registros sin errores de bloqueo. Almacene la decisión y la razón de cada URL para que los equipos puedan auditar por qué una página fue indexada, sostenida, consolidada o retirada.
Modos de falla comunes y cómo solucionarlos
El fallo más común es escalar el recuento de URL antes de probar que la familia de página produce un valor distinto. Arregla eso al reducir el piloto, fortalecer los datos de origen y hacer que los módulos de plantilla estén condicionados a pruebas reales específicas de página. Un segundo fracaso es el inventario huérfano: existen páginas generadas pero no hay enlaces útiles de ruta de navegación a ellas. Arregla eso con los centros de padres y las relaciones contextuales en lugar de confiar en los mapas de sitios XML solos.
Otros problemas recurrentes incluyen registros de fuentes de datos, canónicas conflictivas, indexación accidental de estados vacíos, páginas de ubicación casi duplicadas y reglas de QA que sólo verifican el estado HTTP. Abordar estos controles con la propiedad explícita de la frescura, reglas canónicas deterministas, controles de indexación no cerrados, consolidación de nivel de intención y cheques de contenido rendido.
Editorial QA y cadencia refrescante
Establecer frecuencia de revisión de la velocidad de los datos subyacentes y la decisión del usuario puede cambiar. El inventario o la disponibilidad de alta costura puede necesitar cheques automáticos de frescura cada ciclo de publicación; atributos de referencia estables pueden usar una cadencia más larga. Programar de forma separada muestreo editorial de nivel de plantilla para que una familia de página técnicamente válida no se convierta lentamente en repetitiva, engañosa o rota visualmente.
Los desencadenantes de reabastecimiento deben incluir cambios en el campo de fuente, versiones de plantilla, deriva de intención de búsqueda, caídas de materiales en la indexación válida, cobertura intervincular rota y fallos repetidos de calidad. Grabar el gatillo y la remediación en lugar de cambiar páginas simplemente para hacer que se vean recientemente actualizados.
Cuando guardar las páginas manual o de alto tacto
Mantenga un manual de página cuando la decisión dependa del juicio experto, la investigación original, las reclamaciones sensibles, la lógica de comparación compleja o una narrativa que no pueda ser representada fielmente por datos estructurados. Los centros de categoría de alto valor, las comparaciones estratégicas y las páginas que conforman la confianza de la marca a menudo merecen la propiedad editorial a medida incluso cuando se generan páginas de apoyo.
Un modelo híbrido es generalmente más fuerte que una opción de todo o nada: automatizar hechos de entidad repetibles y QA, mientras que los editores son dueños de las familias de página donde la interpretación, posicionamiento y calidad de evidencia importan más.
Siguiente paso: convertir el contrato de página-familia en un sistema de producción
Si necesita ayuda para diseñar el contrato de datos, reglas de plantilla, arquitectura de enlace interno, puertas de indexación y plan de medición, veaServicios de rendimiento y contenidos WebDesignK SEO. Traiga el resultado de la puerta de calidad de este artículo a la conversación de descubrimiento para que la primera discusión comience con sus limitaciones reales.
FAQ
¿Es SEO programático contra las directrices de Google?
No. La publicación programática es un método de producción. Las políticas de Google se centran en resultados abusivos como las páginas de las puertas y el contenido sin tramites escalado hecho principalmente para manipular las clasificaciones. La familia de página todavía necesita valor útil y diferenciado.
¿Cuántas páginas deberíamos lanzar primero?
No hay número universal. Inicie una muestra que cubra registros normales y casos de borde mientras se sigue siendo manualmente revisorable. Ampliar sólo cuando sus reglas automatizadas y el comportamiento observado de la producción apoyan la expansión.
¿Debería cada URL generada ser indigno?
No. Tratar la indexación como estado decidido por la integridad de datos, la intención, la utilidad, la validez técnica, el descubrimiento y la gobernanza. Los candidatos borrados, escalonados, duplicados o débiles pueden permanecer indignos, consolidados o inéditos.
¿Añade texto más único que resuelve las páginas delgadas?
No por sí mismo. El texto único no es el mismo que el valor único. La página debe cambiar la respuesta a través de datos verificados, módulos útiles, contexto de flujo de trabajo, inventario, evidencia de comparación, prueba local u otra dimensión significativa.
¿Con qué frecuencia deben correr las puertas de calidad?
Ejecute los datos/templarios deterministas cuando cambien los registros de fuentes o plantillas, y programe auditorías recurrentes para la frescura, el orfanato, la deriva de la indexación y los resultados de la página familiar. La cadencia debe reflejar lo rápido que cambian sus datos y el riesgo operacional de las páginas de establo.
¿Cuál es la primera cosa que arreglar si miles de páginas ya están en vivo?
Comience con el inventario y la propiedad de la intención. URLs de grupo por estado de plantilla y publicación, identificar brechas de datos fuente y patrones duplicados, luego fijar causas raíz en el contrato de datos o reglas de plantilla. Evite tratar cada URL débil como un proyecto de reescritura de contenido separado.
Preguntas frecuentes
¿Es SEO programático contra las directrices de Google?
No. La publicación programática es un método de producción, no una violación de políticas por sí misma. El riesgo es lo que hacen las páginas. Las políticas de spam de Google prohíben el abuso de las puertas y el contenido escalado creado principalmente para manipular las clasificaciones sin ayudar a los usuarios. Un sistema programático legítimo todavía necesita páginas útiles, diferenciadas y SEO técnico normal.
¿Cuántas páginas programáticas debemos lanzar primero?
No hay un número seguro universal. Comience con una muestra lo suficientemente grande para ejercitar cada plantilla y caso de borde de datos mientras todavía se está revisando manualmente. Amplíe sólo después de que pueda verificar la renderización, calidad de fuente, descubrimiento de enlace interno, comportamiento canónico, patrones de indexación y resultados útiles del usuario.
¿Debería cada página generada estar en el mapa de sitio XML?
No. Incluye URL canónicas que realmente deseas que los motores de búsqueda descubran y consideren para la búsqueda. Mantén borrados, bloqueados, duplicados, retirados e intencionadamente variantes no indexables fuera del inventario de mapas de sitio indignos.
¿Pueden las etiquetas canónicas resolver las páginas programáticas delgadas o duplicadas?
Las señales canónicas pueden ayudar a consolidar URLs duplicadas o muy similares, pero no convierten páginas débiles en páginas útiles. Si muchas URL no tienen un valor de usuario distinto, corrige el diseño de página-familia o reduce el inventario indable en lugar de utilizar canónicas como sustituto de la diferenciación.
¿Qué debemos medir después de lanzar una familia de página programática?
Medir elegibilidad técnica primero: códigos de estado, renderización, canónicas, membresía de sitios, descubrimiento de los rastreos y muestras de indexación. Luego mida la utilidad de la página por medio de aterrizajes orgánicos cualificados, compromiso con módulos de página específicos, conversiones apropiadas a la intención, tasa de registro de datos y el volumen de URL que necesitan consolidación o podación.
¿Cuándo se poda una página programática?
Considere la consolidación, noindex o eliminación cuando la entidad subyacente es inválida, la página no puede mantener una intención distinta, los datos de origen son estanca, la plantilla produce un valor casi duplicado, o la URL sigue siendo operacionalmente inmantenible. Elija la respuesta basada en si existe un reemplazo útil y si la vieja URL tiene valor que debe ser redirigido.
Sources and assumption boundaries
Fast-changing platform, pricing and search claims were reviewed on 2026-09-19T00:00:00.000Z. Interactive scores and scenarios are clearly labeled planning models, not sourced market benchmarks.
- Google Search Central - Política de Spam para Búsqueda de Google web Fuente primaria para el abuso de las entradas y el abuso de contenidos escalado; revisión del 19 de septiembre de 2026.
- Google Search Central — URL canonicalization Fuente primaria para agrupación duplicada y señales canónicas; revisión 19 de septiembre de 2026.
- Google Search Central - Construir y enviar un mapa de sitio Fuente primaria para URLs de mapas de sitio canónicos, descubrimiento de mapas de sitio y límites de mapas de sitio; revisado 19 de septiembre de 2026.
- Google Crawling Infrastructure — Optimize your rail budget Guía primaria de Google para los inventarios de URL muy grandes o con frecuencia cambiantes; revisado 19 de septiembre de 2026.
- Google Search Central — URL estructura mejores prácticas Fuente primaria para estructura URL rastreable y evitando espacios URL incontrolados; revisados 19 de septiembre de 2026.