Quick answer
Tratar la privacidad de chatbot como un problema de flujo de datos y propiedad. Documentar qué entra en la conversación, qué sistemas la reciben, por qué cada campo es necesario, cuánto tiempo se mantiene, cómo se puede encontrar o eliminar, y quién es el dueño de cada decisión. No asumir el consentimiento es siempre la base legal correcta o que la declaración de un proveedor "cumplido" resuelve sus obligaciones.
Last reviewed: 2026-10-02T00:00:00.000ZChatbot privacy data-flow mapper
Map what your chatbot collects, why it is needed, which system processes it, where it is stored, how long it is kept and how it can be deleted. This is a planning worksheet for your privacy owner/counsel, not a compliance score or legal opinion. Inputs stay in this browser.
- Conversation transcript: document the specific purpose.
- Conversation transcript: identify the processor/system and any downstream handoff.
- Conversation transcript: confirm the processing/storage region.
- Conversation transcript: define or confirm the retention rule.
- Conversation transcript: document the deletion/DSAR path.
- Conversation transcript: assign an accountable owner.
- Email / account identifier: document the specific purpose.
- Email / account identifier: identify the processor/system and any downstream handoff.
- Email / account identifier: confirm the processing/storage region.
- Email / account identifier: define or confirm the retention rule.
- Email / account identifier: document the deletion/DSAR path.
- Email / account identifier: assign an accountable owner.
Plus 6 additional items in the copied summary.
1. Data categories mapped by lifecycle stage
Counts come only from the rows you enter; they show documentation coverage, not legal compliance.
Takeaway: Collection 3/3, Purpose 0/3, Processor 0/3, Storage region 0/3, Retention 0/3, Deletion path 0/3, Owner 0/3.
2. Open review items by field
Use this backlog to focus vendor, engineering and privacy-review questions.
Takeaway: the largest bar is the field with the most unmapped data categories.
3. Per-category lifecycle completeness
Each bar is the number of documented lifecycle fields out of seven for that category.
Text fallback: Conversation transcript 1/7, Email / account identifier 1/7, Human-handoff context 1/7
Source/assumption note: the visualizations count only fields in this worksheet. They do not decide lawful basis, consent requirements, transfer mechanisms, DPIA obligations or whether a vendor arrangement is compliant; those questions require case-specific review.
Tables built for the buying decision
Primary decision table
| categoría de datos | propósito | fuente | procesador/sistema | región | retención | ruta de eliminación | propietario |
|---|---|---|---|---|---|---|---|
| Conversación transcripción | Examen del contexto de apoyo y de la calidad si se justifica | Conversación de usuario | Aplicación de chat + modelo / proveedores de recuperación | Confirme las regiones de procesamiento y almacenamiento reales | Definir de la necesidad operacional y de propósito | Búsqueda/exportación/rendimiento de los modelos en los sistemas primario y de aguas abajo | Producto + privacidad |
| Identificador de la cuenta | Autentar o asociar una solicitud de soporte con una cuenta | Sesión autenticada o entrada del usuario | Identidad de proveedor + CRM / herramienta de soporte | Confirmar las regiones de cuenta y proveedores | Seguir la política de retención de la cuenta y el apoyo | Represión de la cuenta/recurso de trabajo de la Comisión de Gestión de Recursos Humanos | Identidad/apoyo |
| Datos de contacto | Seguimiento de una acción de ventas o soporte solicitada por el usuario | Campos de formulario/chat proporcionados por el usuario | CRM, servicio de asistencia técnica o sistema de enrutamiento de plomo | Confirme destino y subprocesadores | Mantener sólo para el propósito de seguimiento documentado | CRM/ayuda a la eliminación o supresión de la desintegración de la tinta workflow | Operaciones de venta y apoyo |
| Archivo o documento cargado | Responde una solicitud de usuario que requiere el archivo | Subir usuario | almacenamiento de objetos, OCR/parser, tubería de recuperación, proveedor modelo si se envía | Confirme cada aspiradora de procesamiento | Por defecto a menos que haya una necesidad justificada | Eliminar objetos, obtener entradas de texto/índice y copias de corriente | Producto/seguridad |
| Contexto de la mano de obra humana | Permitir que un agente continúe el caso sin hacer que el usuario repita todo | Evento de escalada de Chatbot | Ayuda de escritorio/centro de contacto | Confirme la región de ayuda a la sequía e integraciones | Alinear la política de retención de entradas y privacidad | Ticket/CRM rights-request workflow | Operaciones de apoyo |
Cuestiones de diligencia del vendedor antes de la producción
| vendedor | función | DPA/SCC | uso de la capacitación | subprocesadores | pregunta abierta |
|---|---|---|---|---|---|
| Modelo/Programador de API | Generalmente procesador/servicio proveedor para su contexto de implementación; verifique contrato y propósitos reales | ¿Hay un artículo 28 DPA disponible? ¿Se necesitan los términos de transferencia para su flujo? | ¿Pueden utilizarse los avisos/salidas para la mejora de modelos por defecto, por opt-in o no en absoluto? | ¿Hay una lista de subprocesadores disponibles con avisos de cambio? | ¿Qué datos se registran fuera de la ruta de respuesta de la API y durante cuánto tiempo? |
| Base de datos vectorial / servicio de búsqueda | Procesador de contenido indexado y metadatos | ¿Cubre el acuerdo las incrustaciones almacenadas, metadatos y soporte el acceso? | ¿Se excluye el contenido del cliente de la formación/uso no relacionado? | ¿Qué proveedores de cloud/storage pueden acceder al servicio? | ¿Cómo se eliminan los registros y copias de seguridad después de una solicitud de derechos? |
| Ayuda de mesa / CRM | Procesador o controlador separado dependiendo del arreglo real | ¿El contrato coincide con el desvío y el uso de contacto? | ¿Se reutilizan los datos de conversación para análisis de proveedores o características de IA? | ¿Qué subprocesadores de enriquecimiento, correo electrónico y análisis reciben datos? | ¿Puede el equipo localizar/exportar/deletrear cada registro de entrega atada a una persona? |
| Análisis / observabilidad | Procesador si recibe datos personales; evite enviar datos que no necesita | ¿Se documentan los términos de procesamiento y transferencia de datos? | ¿Se utiliza el contenido de carga útil más allá de la entrega de servicios? | ¿Qué registros, rastreadores y proveedores de errores reciben cargas de pago? | ¿Pueden los identificadores y los cuerpos de mensajes ser redactados antes de la tala? |
| Proveedor de archivos/OCR | Procesador para contenido descargado por el usuario | ¿Los términos cubren los archivos transitorios y el texto derivado? | ¿Se mantienen o se utilizan archivos o textos extraídos para la formación? | ¿Dónde se encuentra OCR/vision? | ¿Cuál es el comportamiento de eliminación verificado para originales, derivados y respaldos? |
Turn this planning result into a scoped review.
Send the assumptions, constraints and result summary. WebDesignK can review the architecture/content/implementation boundary, identify missing discovery inputs and return a prioritized next-step scope.
- Bring: current site/product, constraints, integrations and your tool result.
- You get: a scoped recommendation, open questions and implementation priorities.
instantánea de decisión para los chatbots de RGPD y AI
La forma más rápida de hacer un concreto de revisión de privacidad de chatbot de AI es dejar de hablar de “el chatbot” como una caja. Un asistente de producción es generalmente una cadena: navegador o aplicación, contexto de identidad, código de orquestación, modelo API, capa de recuperación, tienda vectorial, escritorio de CRM/ayuda, analítica, registros y entrega humana. Cada manguera puede cambiar la cuestión de privacidad.
Lo que aprenderás / decidirás
- que las categorías de datos de chatbot y los trabajos de conversación realmente necesitan datos personales;
- donde las funciones de controlador, procesador y proveedor deben ser documentadas en lugar de asumirse;
- cuando el consentimiento es una pregunta que se debe revisar en lugar de una respuesta predeterminada;
- Cómo definir los controles de retención, uso de la capacitación y eliminación;
- Cómo verificar las transferencias y subprocesadores internacionales;
- :: Cómo una solicitud de eliminación de la RAE/DSAR debería pasar por los sistemas de chatbot y downstream;
- cómo preservar el contexto útil de la entrega sin convertir los registros en un archivo de transcripción innecesario.
El único tradeoff más importante es útil operativo contra la colección innecesaria. Un asistente de soporte puede necesitar un número de pedido para recuperar un pedido autorizado por el usuario. Probablemente no necesita que el identificador copiado en cada evento de análisis, traza de modelo y registro de depuración de larga duración. Comience del trabajo a hacer, luego minimizar la ruta de datos.
Esta guía es informativo, no asesoramiento legal. El análisis del RGPD es específico para los hechos. Utilice el mapper interactivo como un artefacto de descubrimiento para su propietario de DPO/privacy o abogado calificado.
1. Mapa de cada punto de contacto personal-data en el chatbot
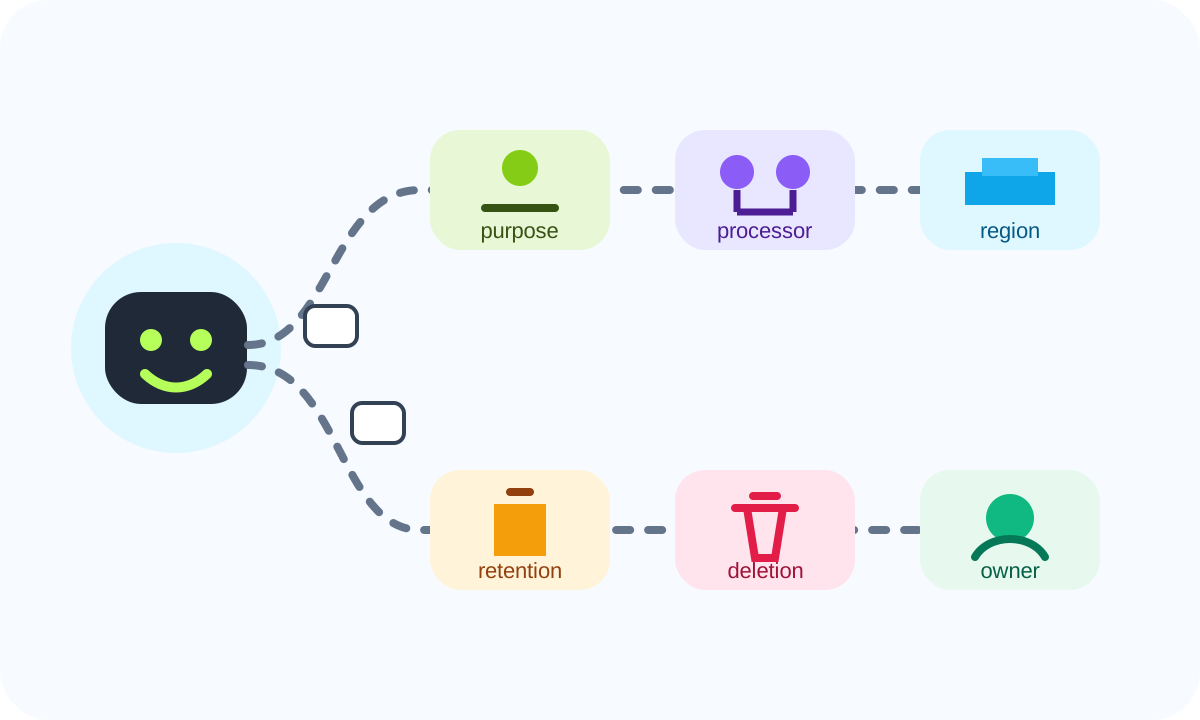
Antes de elegir una base legal, período de retención o cláusula de vendedor, dibuje el flujo. Lista la categoría de datos, el momento en que se recoge, la razón por la que se necesita, cada procesador o sistema interno que lo recibe, región, gatillo de retención, ruta de eliminación y propietario.
Un mapa útil es lo suficientemente específico que un ingeniero puede verificarlo. “Los datos de cambio van a AI” no es específico. “El ID de cuenta deuthenticada es añadido por nuestra API de orquestación, el estado de pedido es sacado de la API de comercio, texto de conversación se envía al proveedor modelo, resumen de la entrega está escrito para ayudar al escritorio, y la telemetría redactada es enviada a la observabilidad” es repasable.
Trabajos de conversación separados antes de mapear campos
Descubrir, apoyar, cualificar, a bordo y conversaciones transaccionales hacen diferentes trabajos. No deben recoger automáticamente los mismos campos.
- Descubrimiento: a menudo necesita pocos datos de identidad o no. El bot puede explicar las capacidades del conocimiento público.
- Apoyo: puede necesitar un contexto de cuenta autenticado o un identificador de tickets, pero sólo después de que el usuario pida ayuda específica para la cuenta.
- Calificación: puede recoger detalles de contacto de negocios, pero los campos deben mapear a un propósito de seguimiento claro.
- A bordo: puede necesitar espacio de trabajo, función o contexto de configuración; evitar copiar secretos en el chat.
- ** Acciones de transacciones:** requieren límites de autorización más fuertes porque el bot puede invocar API que cambian los registros, colocan pedidos o acceden a datos privados.
Por lo tanto, el mapa de privacidad debe seguir el estado de conversación, no sólo los campos de la interfaz de usuario visibles en el mensaje de apertura.
Dibuja el límite de conocimiento
Definir tres caminos de respuesta:
- Retrieval-only: conocimiento público o lleno de permiso puede responder a la pregunta.
- Herramienta/API requerida: datos de cuenta/orden/ticket se recogen sólo después de la autorización y sólo para la acción solicitada.
- Escalado: solicitudes sensibles, ambiguas, de alto riesgo o fuera de la política van a un flujo de trabajo humano o especializado.
Este límite reduce la sobrecolectividad accidental porque el bot no necesita precargar cada campo personal posible “justo en caso”.
2. Funciones de control, procesador y proveedores para aclarar
Los papeles del RGPD dependen de quién determina los propósitos y medios esenciales, no sólo en la etiqueta en un contrato de SaaS. La guía de controlador/procesador de EDPB es útil porque un solo chatbot puede contener varias relaciones.
Su organización será a menudo el controlador para el cliente o el objetivo de calificación de plomo. Un modelo hospedado API, base de datos vectorial, escritorio de ayuda o plataforma de observabilidad puede actuar como procesador cuando procesa datos personales sobre instrucciones documentadas. Pero no traten esa frase como una clasificación universal: algunos proveedores pueden procesar ciertos datos para sus propios fines, y los roles pueden diferir por función.
Preguntas que exponen la ambigüedad del papel
Pregunte a cada proveedor y propietario interno:
- ¿Qué parte decide por qué se procesan los datos?
- ¿Qué parte decide elementos esenciales como categorías de personas/datos o divulgación?
- ¿El proveedor utiliza los avisos, salidas, entradas de soporte o telemetría para la mejora de productos, detección de abusos, análisis o formación de modelos más allá de sus instrucciones?
- ¿Pueden las características opcionales de AI cambiar el propósito del vendedor?
- ¿Qué subprocesadores están involucrados?
- ¿El contrato describe el mismo comportamiento que observó en el producto y la documentación técnica?
Una hoja de cálculo de las adquisiciones debe vincular la respuesta a las pruebas: sección de contratos, DPA, configuración de productos o documentación oficial. “Las ventas dijeron que el RGPD cumple” no es un control de flujo de datos.
3. Cuestiones de fondo y consentimiento legítimos para examinar
Un chatbot necesita una base legal para el procesamiento de datos personales, pero ** el consentimiento no es automáticamente la base correcta**. El RGPD enumera varias bases, y el apropiado depende del propósito y el contexto. Si confía en el consentimiento, la guía de consentimiento del EDPB enfatiza condiciones tales como ser dado libremente, específico, informado e inequívoco, con la posibilidad de retirarse.
Comienza con propósito. “Run un chatbot de AI” es demasiado amplio. Ejemplos de propósitos más estrechos incluyen responder a una pregunta de apoyo solicitada, autenticar una solicitud de cuenta específica, dar seguimiento a una solicitud de ventas, prevenir el abuso o retener un registro de seguridad de corta duración.
Evitar el teatro de consentimiento
Una casilla de verificación no fija un flujo de datos innecesariamente amplio. Si el chatbot no puede explicar lo que cubre el consentimiento, los usos de la corriente baja se agrupan, o el servicio está condicionado al consentimiento que no es en realidad opcional, el diseño necesita revisión.
También separa la base legal para el servicio conversación de usos secundarios opcionales como la mejora de modelos, el seguimiento de marketing o análisis. Una conversación puede contener múltiples propósitos de procesamiento.
Hacer que la interfaz apoye la decisión
En el punto en que la recopilación de datos se hace materialmente diferente, dígale al usuario qué está cambiando. Por ejemplo, un bot público de FAQ que las transiciones a apoyo autenticado deben hacer visible ese límite. Si se puede enviar una carga de archivo a procesadores adicionales, el flujo de carga no debe ocultar ese cambio arquitectónico.
4. Reducción al mínimo de datos y limitación de los objetivos
La minimización de datos se hace práctica cuando cada campo tiene una frase explicando por qué existe. Si el equipo no puede completar “necesitamos este campo porque...”, no lo recoja por defecto.
Un patrón de ingeniería útil es ** revelación progresiva**:
- comenzar con una conversación anónima/pública cuando sea posible;
- solicitar identidad sólo cuando se inicie el trabajo específico de cuenta;
- buscar contexto sensible a través de una llamada de herramienta en lugar de colocar el registro completo en el impulso;
- devolver sólo los campos mínimos necesarios para la respuesta;
- eliminar los resultados de la herramienta transitoria de registros de larga vida a menos que se documente una necesidad separada.
Minimizar los datos derivados también
Los equipos suelen revisar campos obvios como correo electrónico y nombre, pero olvidan artefactos derivados: embeddings, resúmenes de conversaciones, etiquetas de intención, etiquetas de sentimientos, clasificaciones de seguridad, trazas de herramientas y cargas de pago de de depuración. Algunos de ellos pueden todavía estar relacionados con una persona identificable.
El mapper debe incluir registros derivados si pueden vincularse de nuevo a un usuario, cuenta, ticket o sesión. Lo mismo es cierto para los archivos subidos y el texto extraído.
5. Controles de capacitación, retención y transcripción
Haga una pregunta separada para ** uso de formación de proveedores** y ** su propia retención**. No son el mismo control.
Para el entrenamiento de proveedores, verifique los términos y ajustes actuales del producto/API para el servicio exacto que utilice. No asuma la política para un producto de chat de consumidor es idéntica a la API o oferta de empresa. Documentar si los avisos o salidas pueden utilizarse para mejorar el modelo, si existen controles de exclusión/opt-in y qué datos de diagnóstico quedan.
Para su propia retención, defina un gatillo en lugar de escribir “90 días” porque otra empresa lo usa. La norma de retención debe estar conectada al propósito documentado, requisitos legales cuando sea aplicable, operaciones de apoyo, investigaciones de seguridad y comportamiento de respaldo.
Trate copias de seguridad e índices como parte del diseño de eliminación
Un camino de eliminación debe responder:
- ¿Dónde está la transcripción primaria?
- ¿Un resumen copiado a CRM/hospital de ayuda?
- ¿se crean incrustaciones o entradas de índice de búsqueda?
- ¿Los archivos adjuntos se almacenan por separado?
- ¿Qué pasa con copias de seguridad y copias de recuperación de desastres?
- ¿Expone el proveedor API de eliminación o flujos de trabajo de eliminación a nivel de cuenta?
- ¿Cómo se registrará la terminación?
Si la respuesta es “podemos eliminar el ticket pero no encontrar el récord de la tienda vectorial”, la arquitectura no está operativamente lista para solicitudes de derechos.
6. Transferencia internacional y diligencia de proveedores
Las transferencias internacionales son una cuestión de flujo de datos. En primer lugar, determinar qué entidades reciben datos personales y de dónde. Luego revise el mecanismo de transferencia aplicable y la documentación de proveedores con su equipo de privacidad.
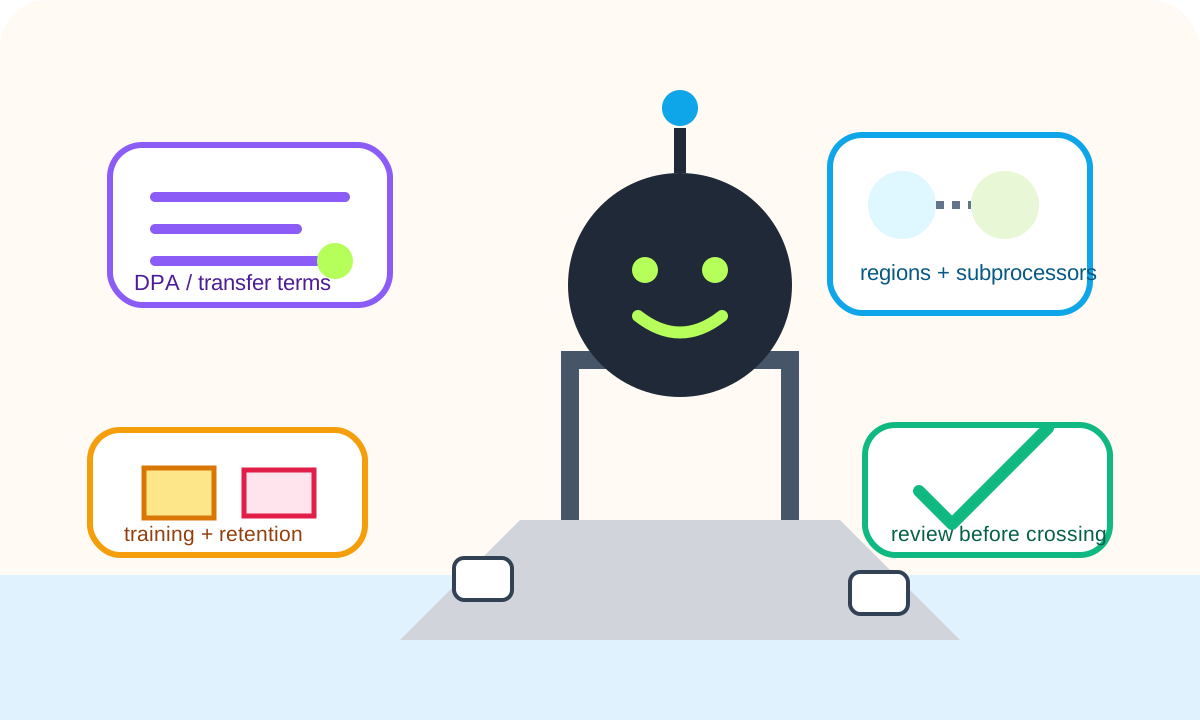
La Comisión Europea publica los materiales de las Cláusulas Contractuales vigentes. Los SCC pueden ser pertinentes en algunos arreglos de transferencia, pero insertar “SCC” en una hoja de cálculo no es el fin de la diligencia. El equipo todavía necesita saber la cadena de transferencia, las ubicaciones de subprocesadores, las medidas técnicas y si el contrato coincide con el despliegue real.
El examen del proveedor debe seguir la configuración de características
Un proveedor puede tener múltiples regiones, modos de registro, complementos de IA y modelos de acceso de soporte. Grabar la configuración que realmente habilita. Si la respuesta cambia cuando un administrador se vuelve “mejorar con los datos del cliente”, “Sumarios de la IA” o una nueva integración analítica, ese ajuste pertenece a la gestión del cambio.
Utilice la tabla de diligencia de proveedores abajo como punto de partida, luego reemplazar filas genéricas con sus verdaderos proveedores.
7. DSAR, eliminación y derechos de usuario workflows
Un aviso de privacidad puede prometer derechos, pero la ingeniería tiene que hacer que esos derechos sean ejecutables. Para un chatbot, la parte dura es a menudo resolución de identidad a través de sistemas.
Crear una solicitud de prueba antes del lanzamiento: “Encontrar y eliminar/exportar los registros asociados con este usuario de prueba.” Siga a través del almacenamiento de chat, escritorio CRM/help, registros de modelo/vendor cuando corresponda, almacenamiento de objetos, índice de vectores y analítica. Observe dónde se detiene la automatización y comienza un paso manual.
No deje que el chatbot haga determinaciones legales
El bot puede recoger una solicitud y enrutarlo, pero no debe decidir independientemente si una excepción se aplica o si la evidencia de identidad es suficiente. Es un proceso de negocios y de privilegios de propiedad.
El registro de entrega debe incluir el tipo de solicitud, identificadores verificados disponibles, sistemas probablemente involucrados, timetamp y cola responsable. Evite copiar más contenido de transcripción que el revisor necesita.
8. Despliegue humano y escalada de datos sensibles
Un fuerte chatbot sabe cuándo parar. Define la escalada de los factores desencadenantes para categorías sensibles, situaciones de uso vulnerable, controversias por cuenta, cuestiones de pago, solicitudes jurídicas, incidentes de seguridad y cualquier dominio en que la política requiera una persona capacitada.
El handoff debe preservar el contexto suficiente para evitar que el usuario repita toda la conversación:
- meta del usuario;
-
- la razón de la escalada;
- resumen de conversación concisa;
- identificadores autenticados pertinentes;
- el consentimiento/preferencia si importa el siguiente paso;
-
- las medidas de instrumentos ya adoptadas;
- enlaces a registros en lugar de copiar cargas de pago sensibles cuando sea posible.
Prueba cinco clases de conversación
Su conjunto de evaluación debe incluir:
- Feliz ruta: solicitud de rutina respondida con los datos mínimos previstos.
- Ambigua: el usuario pregunta algo que podría ser público o específico de la cuenta.
- ** Datos de cuento:** conflictos de contenido de recuperación con una nueva fuente.
- Permission boundary: usuario pide los datos de otra persona/cuenta.
- Adversarial: intentos rápidos de extraer contexto oculto, instrucciones del sistema o registros.
Para cada prueba, registre si el bot recuperado, utiliza una herramienta, abstenido o escalado. Las fallas de privacidad a menudo aparecen como fallas de enrutamiento antes de que aparezcan como problemas de texto de política.
9. Registro de seguridad sin recolecciones
Los registros son útiles para la disponibilidad, seguridad, abuso y depuración, pero también son un lugar común donde se propagan los datos personales. Diseño de observabilidad por lo que el evento predeterminado es estructurado y mínimo.
Preferir campos como tipo de evento, ID de solicitud, nombre modelo/herramienta, latencia, código de resultados y referencia pseudonymous sesión. Agregue el contenido de la respuesta/inmediación únicamente cuando haya una necesidad documentada de depuración, con controles de acceso y retención corta.
Redactantes antes de la exportación
Si la telemetría deja su límite de aplicación, redacte o tokenize valores sensibles antes de que el SDK logging los envíe. Es mucho más difícil limpiar datos después de que ha alcanzado múltiples procesadores de registro y copias de seguridad.
Crear niveles de registro separados para la solución de problemas de producción versus revisión de contenido muestrado. Una manta “perdónea todo porque podemos necesitarlo más tarde” conflictos de política con minimización y hace que la respuesta a incidentes sea más difícil.
10. Lista de verificación y documentación de privacidad pre-lanzamiento
Antes de la producción, los propietarios de ingeniería, producto, seguridad y privacidad deben poder responder a las mismas preguntas de arquitectura.
- Flujo de datos*
- Cada categoría de datos personales tiene un propósito, fuente, procesador/sistema, región, regla de retención, vía de eliminación y propietario.
- Las llamadas Herramienta/API son campos mínimos de recepción y de devolución.
- Los datos derivados, como resúmenes, incrustaciones y trazas, se incluyen cuando son pertinentes.
Controles de proveedores
- Las funciones de procesador y los acuerdos de asociación se documentan cuando proceda.
- Los subprocesadores y regiones son conocidos por la configuración habilitada.
- El uso de capacitación/mejora de productos se verifica para el nivel exacto del producto/API.
- Se han examinado preguntas de transferencia internacional con el propietario de la privacidad.
** Derechos de los usuarios**
- Un usuario de prueba se puede encontrar en sistemas de chatbot y downstream.
- Se documentan las medidas de exportación/deleción, incluidos los índices, los anexos y los registros de entrega.
- Los revisores humanos, no el chatbot, poseen decisiones de excepción y de verificación de identidad.
- Seguridad operacional*
- Los avisos de datos sensibles y de permisos están en el conjunto de evaluación.
- El desvío humano preserva la razón, el contexto y el estado de identidad/consentimiento sin dejar de lado datos innecesarios.
- Los registros se redactan, controlan el acceso y se mantienen con un propósito definido.
- Los cambios a los proveedores, regiones, características de IA o la tala de bitácora activan una revisión de privacidad.
Mantenga un registro de cambios después del lanzamiento
La revisión de la privacidad no es una puerta de lanzamiento única. Cambios de registro que alteran el flujo de datos: un nuevo modelo o proveedor de recuperación, una integración de soporte adicional, una región de alojamiento diferente, retención de transcripciones más largas, un nuevo SDK de análisis, una función de descarga de archivos o un entorno que permite el uso adicional de proveedores. Para cada cambio, tenga en cuenta el propietario, la razón, las categorías de datos afectadas y si el DPA, el análisis de transferencia, el aviso, los controles de seguridad o el flujo de trabajo de eliminación necesita otro examen.
Programar controles de la realidad periódica contra la configuración de producción. Compare el mapa documentado con la configuración de proveedores habilitados, destinos de red, cargas de pagos de registro y flujos de trabajo de apoyo. Esto es especialmente útil después de que los equipos permiten nuevas características de inteligencia artificial en herramientas que fueron aprobadas originalmente con un propósito más estrecho. El objetivo es simple: el diagrama, los contratos y el sistema de funcionamiento deben describir el mismo flujo.
Utilice el mapper como un paquete de revisión
Complete el mapper interactivo de flujo de datos, copie su resumen de revisión y tráigalo a su propietario de privacidad o asesor junto con la tabla de diligencia del proveedor, diagrama de arquitectura y configuración de producto real. Eso convierte en una vaga “¿Es nuestro chatbot RGPD compatible?” reuniéndose en una lista de preguntas concretas y contestables.
Si necesita ingeniería ayuda a implementar el límite —retrieval de la permisión-consciente, llamadas de herramientas, redes, flujos de trabajo de eliminación, mano humana y observabilidad—verDesarrollo de chatbots AIo continuar conArquitectura de chatbot de RAG, chatbot de AI vs chat en vivo, yLímites de automatización de la comercialización de AI.
Revisado por última vez: 2 de octubre de 2026. Cambio de comportamiento de los proveedores, orientación regulatoria y configuración de productos; verifique la documentación oficial actual antes del lanzamiento.
Preguntas frecuentes
¿Los chatbots AI siempre necesitan el consentimiento del usuario bajo RGPD?
No. El RGPD requiere una base legal para cada propósito de procesamiento, pero el consentimiento es sólo una base posible y tiene condiciones estrictas. La base correcta depende del propósito y la relación específicos, así que documente el propósito primero y reviselo con su propietario o abogado de privacidad.
¿Podemos mantener las transcripciones de chatbot indefinidamente para mejorar la calidad?
La retención indefinida es difícil de reconciliar con la limitación de almacenamiento sin necesidad específica y documentada. Defina por qué se mantienen las transcripciones, que pueden acceder a ellas, si pueden minimizarse o anonimato, y un desencadenante de eliminación que coincide con el propósito.
¿Es suficiente un DPA de proveedor para el cumplimiento del RGPD?
No. Un DPA es importante cuando un proveedor actúa como su procesador, pero todavía necesita entender el flujo de datos, instrucciones, seguridad, subprocesadores, transferencias, retención y operaciones de investigación de derechos.
¿Qué debe pasar cuando un usuario pide al chatbot que borre sus datos?
El chatbot puede capturar la solicitud, pero el flujo de trabajo operativo debe localizar los registros pertinentes en todo el sistema de chat y procesadores de corriente abajo, autenticar al solicitante cuando corresponda, enviar la solicitud al equipo responsable y completar documentos o cualquier excepción legal.
¿Deberían contener los registros de chatbots completos de las respuestas y los avisos?
No automáticamente. Los registros deben diseñarse en torno a un propósito definido de solución de problemas o seguridad. Preferir eventos estructurados, identificadores pseudonymous, redescuidación y retención corta donde no es necesario el contenido completo de conversación.
¿Este artículo determina si nuestro chatbot es compatible con el RGPD?
No. Es una guía de planificación de ingeniería y adquisiciones. Las obligaciones del RGPD son específicas de los hechos y pueden depender de la jurisdicción, propósito, categorías de datos, escala, proveedores y otros factores. Utilice el mapper para preparar una mejor revisión con su propietario de DPO/privacy o abogado calificado.
Sources and assumption boundaries
Fast-changing platform, pricing and search claims were reviewed on 2026-10-02T00:00:00.000Z. Interactive scores and scenarios are clearly labeled planning models, not sourced market benchmarks.
- EUR-Lex — Reglamento (UE) 2016/679 (RGPD) Texto oficial del RGPD utilizado para los principios, bases legales, procesador, seguridad, transferencia y referencias de derechos de subjeto de datos en esta guía.
- EDPB — Directrices 07/2020 sobre conceptos de controlador y procesador Orientación final de la Junta de Coordinación de la Gestión sobre la identificación de funciones de controlador, control conjunto y procesador y el enfoque de substancias.
- EDPB - Directrices 05/2020 sobre el consentimiento Orientación oficial de la Junta sobre las condiciones para el consentimiento válido en virtud del RGPD.
- European Commission — Standard Contractual Clauss publications Fuente oficial de la Comisión para los CCE utilizados en los arreglos de controlador/procesador y en los escenarios internacionales de transferencia.
- EDPB — Opinión 28/2024 sobre datos personales en el contexto de los modelos AI EDPB opinión sobre el anonimato, legitimate interest y consecuencias del procesamiento ilícito de datos personales en el desarrollo de modelos AI and deployment.